Datenaufbereitung, EDA, Modelltraining und Ergebnisexport in einem dokumentierten Workflow.
Predictive Analytics · IHK-Abschlussprojekt
Wer ist bereit
für den nächsten Job?
Ein End-to-End-Teamprojekt zur Erkennung von Jobwechselbereitschaft: von unvollständigen HR-Daten über sechs Klassifikationsmodelle bis zum interaktiven Power-BI-Dashboard.
Fallstudie lesen →StatusAbgeschlossen · Mai 2024
RolleVierköpfiges Teamprojekt
RepositoryProjektartefakte privat
Verifikation6 Modelle · Ergebnis offen dokumentiert
19.158Datensätze
6Modelle im Vergleich
78,21 %beste Accuracy
1Power-BI-Dashboard
Der Auftrag
Potenziale erkennen, bevor die Ansprache beginnt.
HRmony Consultants wollte Personen identifizieren, die für einen Jobwechsel offen sind. Ein erworbener Datensatz enthielt Angaben zu Demografie, Ausbildung, Berufserfahrung und Beschäftigungssituation. Das Feld target markierte, ob eine Person nach einer neuen Stelle suchte.
Das vierköpfige Projektteam sollte daraus ein wiederverwendbares Klassifikationsmodell und ein verständliches Kundenprofil für Recruiting und Marketing entwickeln. Die Arbeit entstand als IHK-Abschlussprojekt im Mai 2024.
Datenaufbereitung
20.733 fehlende Werte waren der eigentliche Startpunkt.
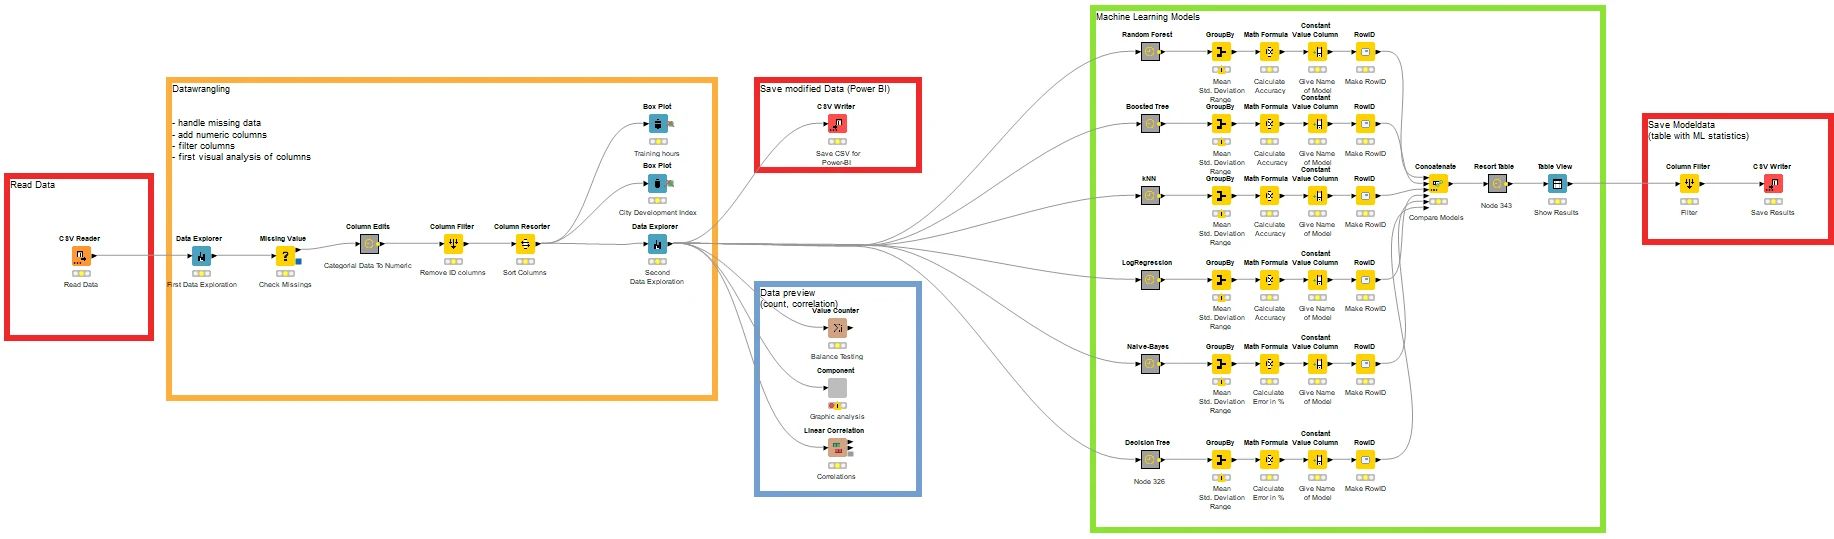
Die 19.158 Zeilen enthielten insgesamt 20.733 fehlende Einzelwerte. In KNIME wurden sie behandelt, kategoriale Merkmale numerisch abgebildet, nicht benötigte Felder entfernt und Spalten für Analyse und Dashboard neu geordnet.
CSV einlesen→Missing Values→Merkmale kodieren→EDA & Export
KNIME Workflow
Eine Pipeline vom Rohdatensatz bis zum Modellvergleich.
Nach Datenprüfung und Transformation verzweigt der Workflow in sechs Modellfamilien. Parameteroptimierung und wiederholte Partitionierung machen die Ergebnisse vergleichbar. Die Kennzahlen werden anschließend in einer gemeinsamen Tabelle zusammengeführt.
Modellvergleich
Gradient Boosted Trees lagen knapp vorn.
Die gesetzte Zielmarke von 80 Prozent wurde nicht erreicht. Das beste Modell kam auf 78,21 Prozent Accuracy. Der geringe Abstand zum Random Forest und die unausgewogene Zielklasse gehören zur sachlichen Einordnung.
Power BI
Aus Modelloutput wurde eine Entscheidungshilfe.
Der aufbereitete Export bildete die Grundlage für einen einseitigen Power-BI-Bericht. Power Query kategorisierte und rundete Werte, ergänzte bedingte Spalten und bereitete gezielte Filter für Erfahrung, Trainingsstunden und den Entwicklungsindex des Wohnorts vor.
Das Ergebnis verbindet Modellbewertung mit einem explorativen Kundenprofil. Recruiter können Merkmale potenzieller Jobwechsler untersuchen, ohne im KNIME-Workflow arbeiten zu müssen.
Interaktive Exploration der aufbereiteten Merkmale und Zielgruppen.
Projektbeschreibung und Abschlusspräsentation mit Hypothesen, Metriken und Grenzen.
Einordnung
Ein gutes Ergebnis darf sein Ziel verfehlen.
Die Hypothese einer Accuracy von mindestens 80 Prozent wurde nicht bestätigt. Das Projekt dokumentierte 78 Prozent als reales Ergebnis, statt die Zielmarke nachträglich umzudeuten.
Für einen produktiven Einsatz wären zusätzliche Schritte nötig: Recall und Precision der positiven Klasse vollständig vergleichen, Klassenungleichgewicht behandeln, Fairness nach sensiblen Merkmalen prüfen und die Herkunft sowie rechtliche Nutzbarkeit der Daten sauber validieren.
Vom Modell zum möglichen Produkt
Accuracy allein beantwortet keine Recruiting-Frage.
Für eine reale Entscheidungshilfe müssten Treffer und Fehlklassifikationen aus Sicht der positiven Zielklasse bewertet, Schwellenwerte fachlich gewählt und sensible Merkmale auf Fairnessrisiken geprüft werden.
Vier Perspektiven, ein Workflow
Datenaufbereitung, Analyse, Modellierung, Power BI und Präsentation mussten zu einem konsistenten Projektergebnis zusammengeführt werden.
Sechs Verfahren vergleichbar machen
Gemeinsame Partitionierung und strukturierte Kennzahlen verhinderten, dass Modelle nur nach Einzeleindrücken beurteilt wurden.
Vom Score zum Kundenprofil
Das Dashboard übersetzte technische Ergebnisse in filterbare Merkmale, die Recruiting und Marketing ohne KNIME untersuchen konnten.
Grenzen gehören zum Ergebnis
Klassenungleichgewicht, Datenherkunft, rechtliche Nutzbarkeit und mögliche Verzerrungen bleiben offene Prüfungen vor einem produktiven Einsatz.
Heute würde der nächste Schritt anders aussehen
Statt nur Accuracy zu optimieren, würde ich eine Kostenmatrix für False Positives und False Negatives definieren, Precision/Recall und Kalibrierung vergleichen und die gesamte Pipeline reproduzierbar versionieren.